bloom-filter
场景
假设你现在要处理这样一个问题,你有一个网站并且拥有很多访客,每当有用户访问时,你想知道这个ip是不是第一次访问你的网站。
hashtable 可以么
一个显而易见的答案是将所有的ip用hashtable存起来,每次访问都去hashtable中取,然后判断即可。但是题目说了网站有很多访客, 假如有10亿个用户访问过,每个ip的长度是4 byte,那么你一共需要4 * 1000000000 = 4000000000Bytes = 4G , 如果是判断URL黑名单, 由于每个URL会更长,那么需要的空间可能会远远大于你的期望。
bit
另一个稍微难想到的解法是bit, 我们知道bit有0和1两种状态,那么用来表示存在,不存在再合适不过了。
加入有10亿个ip,我们就可以用10亿个bit来存储,那么你一共需要 1 * 1000000000 = (4000000000 / 8) Bytes = 128M, 变为原来的1/32, 如果是存储URL这种更长的字符串,效率会更高。
基于这种想法,我们只需要两个操作,set(ip) 和 has(ip)
这样做有两个非常致命的缺点:
- 当样本分布极度不均匀的时候,会造成很大空间上的浪费
我们可以通过散列函数来解决
- 当元素不是整型(比如URL)的时候,BitSet就不适用了
我们还是可以使用散列函数来解决, 甚至可以多hash几次
布隆过滤器
布隆过滤器其实就是bit + 多个散列函数, 如果经过多次散列的值再bit上都为1,那么可能存在(可能有冲突)。 如果 有一个不为1,那么一定不存在(一个值经过散列函数得到的值一定是唯一的),这也是布隆过滤器的一个重要特点。
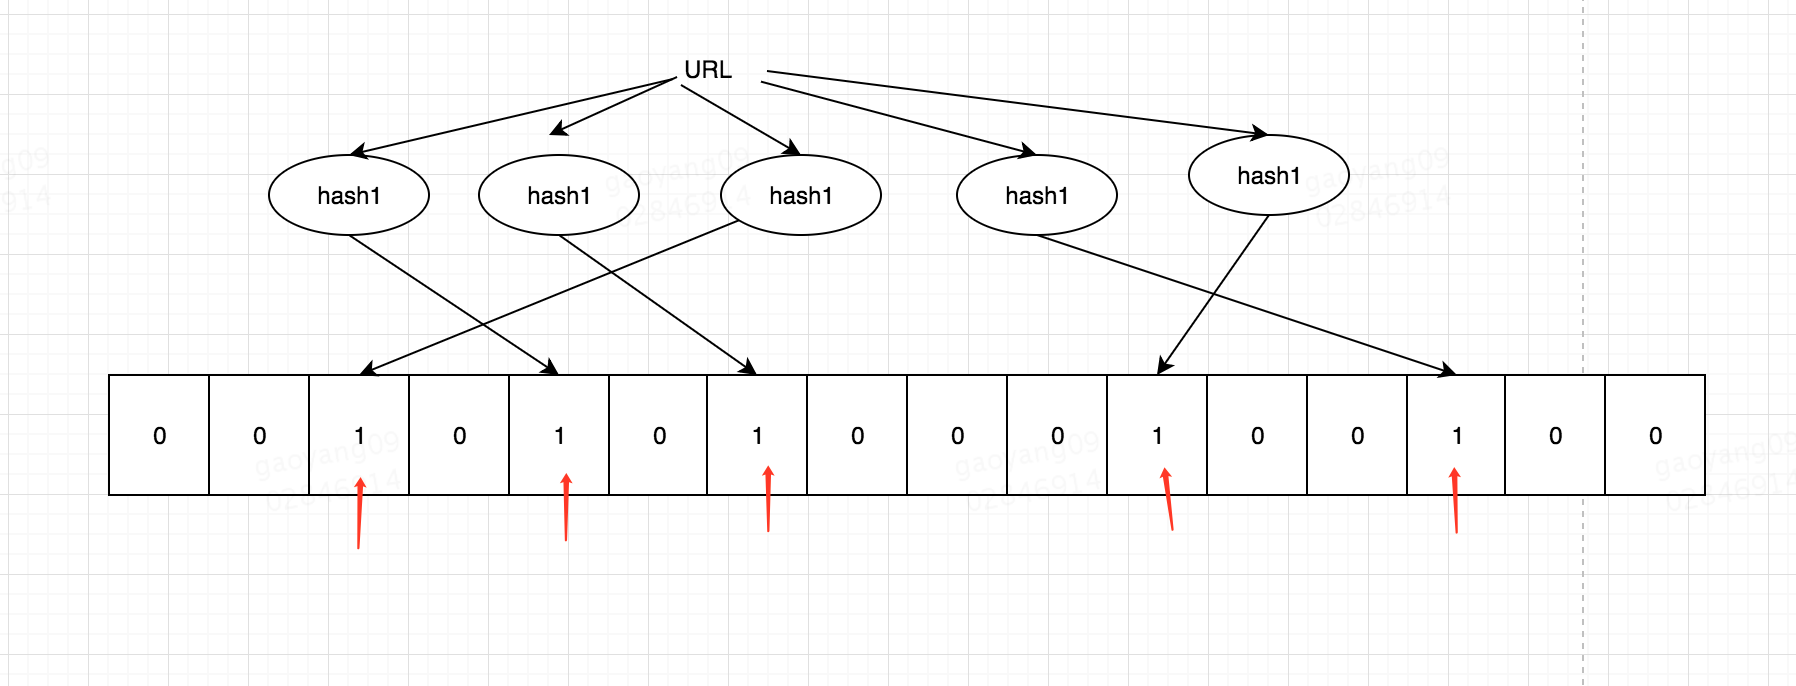
布隆过滤器的应用
- 网络爬虫 判断某个URL是否已经被爬取过
- K-V数据库 判断某个key是否存在;比如Hbase的每个Region中都包含一个BloomFilter,用于在查询时快速判断某个key在该region中是否存在。
- 钓鱼网站识别。浏览器有时候会警告用户,访问的网站很可能是钓鱼网站,用的就是这种技术
基本概念
如果想判断一个元素是不是在一个集合里,一般想到的是将所有元素保存起来,然后通过比较确定。链表,树等等数据结构都是这种思路. 但是随着集合中元素的增加,我们需要的存储空间越来越大,检索速度也越来越慢。不过世界上还有一种叫作散列表(又叫哈希表,Hash table)的数据结构。它可以通过一个Hash函数将一个元素映射成一个位阵列(Bit Array)中的一个点。这样一来,我们只要看看这个点是不是 1 就知道可以集合中有没有它了。这就是布隆过滤器的基本思想。
Hash面临的问题就是冲突。假设 Hash 函数是良好的,如果我们的位阵列长度为 m 个点,那么如果我们想将冲突率降低到例如 1%, 这个散列表就只能容纳 m/100 个元素。显然这就不叫空间有效了(Space-efficient)。解决方法也简单,就是使用多个 Hash,如果它们有一个说元素不在集合中,那肯定就不在。如果它们都说在,虽然也有一定可能性它们在说谎,不过直觉上判断这种事情的概率是比较低的。
优点
相比于其它的数据结构,布隆过滤器在空间和时间方面都有巨大的优势。布隆过滤器存储空间和插入/查询时间都是常数。另外, Hash 函数相互之间没有关系,方便由硬件并行实现。布隆过滤器不需要存储元素本身,在某些对保密要求非常严格的场合有优势。
布隆过滤器可以表示全集,其它任何数据结构都不能;
k 和 m 相同,使用同一组 Hash 函数的两个布隆过滤器的交并差运算可以使用位操作进行。
缺点
但是布隆过滤器的缺点和优点一样明显。误算率(False Positive)是其中之一。随着存入的元素数量增加,误算率随之增加。但是如果元素数量太少,则使用散列表足矣。
另外,一般情况下不能从布隆过滤器中删除元素. 我们很容易想到把位列阵变成整数数组,每插入一个元素相应的计数器加1, 这样删除元素时将计数器减掉就可以了。然而要保证安全的删除元素并非如此简单。首先我们必须保证删除的元素的确在布隆过滤器里面. 这一点单凭这个过滤器是无法保证的。另外计数器回绕也会造成问题。
References: